

メモリ32GBでローカルAIはどこまで動く?必要な容量の目安
ChatGPTやClaudeのような文章生成AIは、通常、インターネット経由でクラウド上のサーバーを利用します。手軽に使える一方、利用回数や入力データの扱い、選べるモデルなどは、サービスの仕様に沿って利用する必要があります。
これに対し、文章生成用のAIモデルを自分のパソコンへ保存し、パソコン内で動かす方法を「ローカルLLM」と呼びます。ローカルLLMは、自分のパソコンでAIを動かす「ローカルAI」の一つです。「メモリ32GBで実際にどこまで動かせるのだろう」と気になっている方も多いのではないでしょうか。
結論からいうと、メモリ32GBで使うなら、7B~14BクラスのローカルLLMがひとつの目安です。モデルが使う数値を簡略化して、データ量を減らした「4ビット量子化モデル」を選ぶと、OSやほかのアプリが使う分を残しやすいためです。30B前後も読み込めるモデルがありますが、32GBではメモリの余裕が少なくなります。
ここで出てくる「B」はモデルの大きさを、「量子化」はモデルが使う数値を簡略化してデータ量を減らす方法を表します。詳しい意味は後ほど順番に説明するため、まずは「7B~14Bは32GBに収まりやすく、30B前後から余裕が少なくなる」と押さえてください。この記事では、ローカルLLMの仕組みからメモリ32GBで動かせるモデルの目安まで、これからローカルLLMを試したい初心者の方にもわかりやすく紹介します。
この記事でわかること
- ローカルLLMとは何か、自分のパソコンでAIを動かす仕組み
- メモリ32GBで動かせるモデル規模と必要容量の目安
- 量子化でモデルのデータ量を減らす仕組み
- 32GBのままでよい場合と64GBを検討したい場合
そもそも「ローカルLLM」とは?自分のパソコンでAIを動かす仕組み
ChatGPTやClaudeのような文章生成AIでは、文章を生成する仕組みとしてLLM(大規模言語モデル)が使われています。通常はインターネット経由でクラウド上のサーバーにアクセスして利用します。一方、公開されているLLMを自分のパソコンへダウンロードし、文章の生成や要約などをパソコン内で行う使い方が「ローカルLLM」です。
ローカルAIは、自分のパソコンでAIモデルを動かす使い方の総称です。文章生成のほか、画像生成や音声認識なども含まれます。本記事で扱うローカルLLMは、ローカルAIのうち、文章の生成や要約に使うモデルを指します。
ローカルLLMは、使用するモデルを自分で選びやすく、入力内容を外部のAIサービスへ送らずに処理できます。モデルのダウンロードにはインターネット接続が必要ですが、オフライン動作に対応したソフトとモデルであれば、ダウンロード後の処理をパソコン内で完結できます。ただし、モデルを動かすためのCPUやメモリなどは、自分のパソコン側で用意する必要があります。
ローカルLLMを動かす方法としては、「Ollama」や「LM Studio」などのソフトが代表的です。AIモデルの検索やダウンロード、実行に必要な機能がまとめられているため、一から複雑な環境を構築しなくてもローカルLLMを試せます。利用する場合は公式サイトから入手し、対応OSや動作条件を確認してください。
ローカルLLMは、入力内容を外部のAIサービスへ送らずに処理できることが利点です。ただし、モデルの規模が大きくなるほど、モデルを読み込むためのメモリ(RAM)も多く必要になります。メモリの基本的な役割や容量の考え方については、 パソコンのメモリとは「役割・容量・選び方」の基本もあわせてご覧ください。
本記事では、パソコン本体のメモリ(RAM)を中心に説明します。ただし、ローカルLLMの処理にはRAMだけでなく、グラフィックボード専用のメモリ(VRAM)も関係します。
メモリ32GBを検討する際は、グラフィックボードのVRAM容量もあわせて確認してください。VRAMがない、または容量が不足している場合は、CPUとパソコン本体のメモリを使う処理が増え、生成速度が大きく低下することがあります。
VRAM容量の確認方法:Windowsでは、「タスク マネージャー」→「パフォーマンス」→「GPU」を開くと、グラフィックボード名と「専用GPUメモリ」の容量を確認できます。
メモリ32GBで動かせるモデルの目安
ローカルLLMは、グラフィックボードを使わず、CPUとパソコンのメモリ(RAM)だけでも動かせます。グラフィックボードを使う場合は、モデルの全部または一部を、グラフィックボード専用のメモリである「VRAM」に読み込んで処理します。
VRAMにモデル全体が収まれば高速に処理しやすくなりますが、収まらない部分をRAMで処理する場合や、グラフィックボードを使わない場合は、RAMの容量が重要です。この記事では、こうした使い方を含めて「RAMが32GBある場合に、どの規模のモデルを扱いやすいか」を見ていきます。
LLMのモデル名には、「7B」「14B」「32B」のように、Bが付いた数字が使われます。Bは「Billion(10億)」の略で、7Bなら約70億、14Bなら約140億のパラメータを持つことを表します。パラメータとは、AIが言葉のつながりを判断し、文章の続きを考えるために使う数値です。まずは「Bの数字が大きいほど、モデルの規模も大きくなりやすい」と考えるとわかりやすいでしょう。ただし、回答の質はモデルの設計や学習内容にも左右されるため、Bの数字だけでは決まりません。
モデルが大きいほど、基本的には多くのメモリが必要です。ただし、同じ規模でも、モデルが使う数値を簡略化してデータ量を減らしたものを選ぶと、必要量を抑えられます。以下では、Ollamaで配布されている「4ビット量子化モデル」を例にします。量子化の詳しい仕組みは、次の章で説明します。
- 7B~8Bクラス:モデル本体は約5GBです。メモリ32GBなら、OSやブラウザなどが使う分を残しながら読み込みやすい規模です
- 12B~14Bクラス:モデル本体は約9GBです。メモリ容量の面では32GBに収まり、ほかのアプリと併用する余地も残しやすくなります
- 27B~32Bクラス:モデル本体は約19~20GBです。32GBでも読み込めるモデルはありますが、長い文章を扱う設定やほかのアプリの使用量によっては、メモリ不足になる場合があります
- 70Bクラス:4ビット量子化モデルでも約40~43GBあるため、モデル本体だけで32GBを超えます。メモリ32GBだけで扱うには向きません
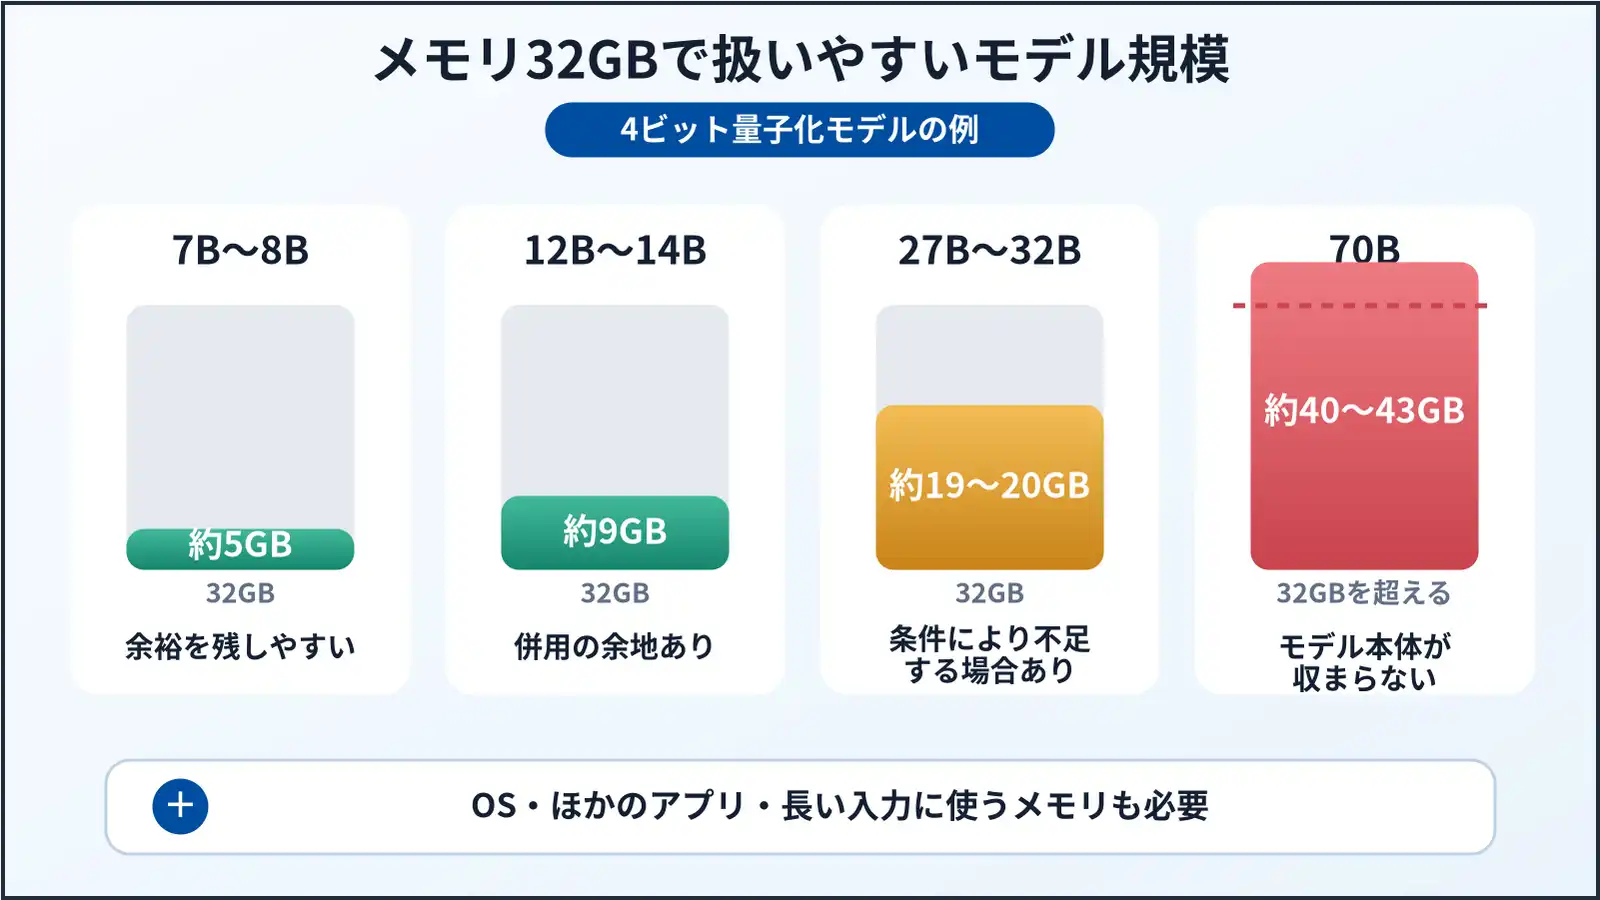
ここで示した数値はモデルファイル本体の目安です。実行時には、入力した文章や生成中の内容を保持する領域なども追加で使います。扱う文章を長くするほど必要量が増えるため、モデル本体が32GB未満でも必ず動くとは限りません。また、メモリに収まることと応答が速いことは別で、生成速度はCPUやグラフィックボード、メモリ帯域などにも左右されます。
なぜ必要な容量を減らせる?「量子化」という技術
量子化とは、AIモデルが使う数値を元の状態より少ない情報量で表し、必要なデータ量を減らす技術です。一般的なファイル圧縮のように元の状態へ完全に戻す方法ではなく、数値の細かさを減らして軽くします。そのため、必要なメモリを抑えられる一方、量子化の方式や段階によっては回答の正確さや文章の安定性に影響する場合があります。
たとえば8BモデルのQwen3は、量子化していないFP16形式では約16GBです。8ビット量子化のQ8_0では約8.9GB、4ビット量子化のQ4_K_Mでは約5.2GBまで減ります。同じ8Bモデルでも、選ぶファイルによって必要な容量が大きく変わることがわかります。
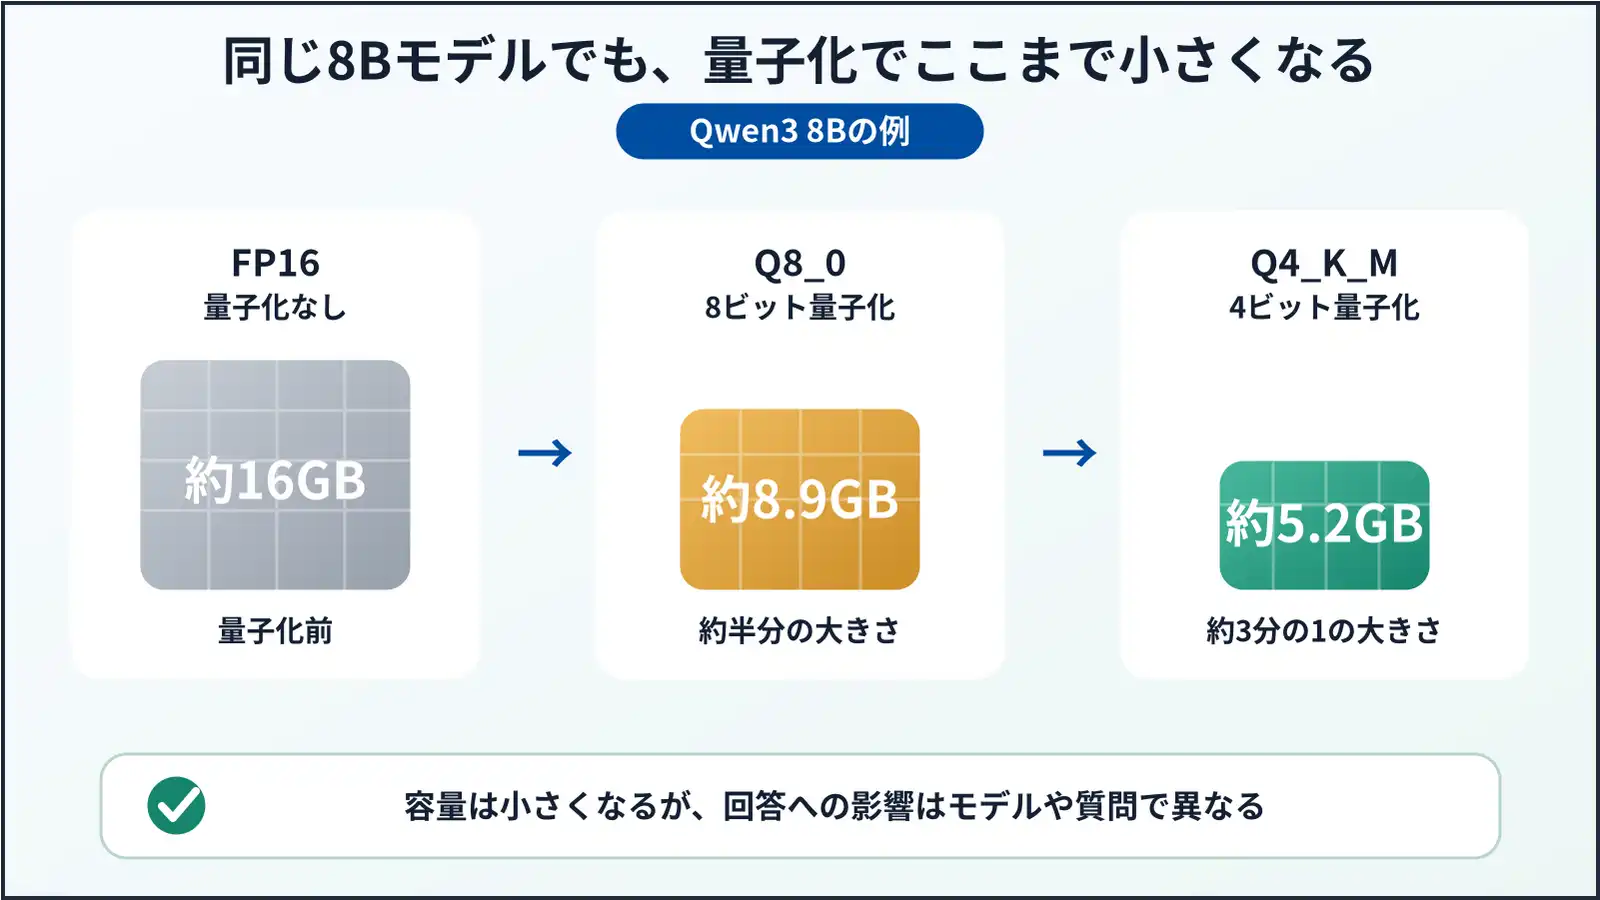
量子化による影響は、モデルの種類、量子化方式、質問内容によって変わるため、「4ビットなら品質が何%下がる」と一律には示せません。容量を減らすことだけを優先すると回答へ影響が出る場合があるため、初めて試す場合は、必要量と回答品質のバランスを取りやすいQ4_K_Mなどの4ビット量子化モデルが選択肢になります。
Ollamaでは、モデル名だけを指定して取得したときに、Q4_K_Mのファイルが選ばれるモデルもあります。ただし、同じモデルでもQ8_0やFP16など複数のファイルが用意されているため、ダウンロード前にモデルのタグ、ファイルサイズ、量子化方式を確認してください。
32GBで足りないと感じるのはどんなとき?
メモリ32GBは、4ビット量子化した7B~14Bクラスを中心に使う場合には選びやすい容量です。一方、次のような使い方では、32GBの余裕が少なくなります。
- 27B~32Bクラスで長い文章を扱いたい場合:モデル本体が約19~20GBあるため、入力できる文章量を増やす設定や、ほかのアプリの使用量によっては32GBに収まらない場合があります
- 複数のモデルを同時に読み込む場合:文章生成用とコーディング用など、複数のモデルを同時に保持すると、それぞれのモデル本体と実行用の領域が必要になります
- ローカルLLMとメモリを多く使う作業を同時に行う場合:動画編集や高解像度の画像編集などを並行すると、モデル以外に使えるメモリが少なくなります
また、70Bクラスの4ビット量子化モデルは約40~43GBあるため、メモリ32GBにはモデル本体が収まりません。こうした大規模モデルを試したい場合や、ローカルLLMと重い作業を同時に行いたい場合は、64GBへの増設を検討できます。詳しくは、メモリ64GBは必要?ローカルAIで70Bモデルを動かすための目安を解説をご覧ください。
16GBから32GBへ増設する前に確認すること
現在16GBで、7B~14BクラスのローカルLLMを使いたい場合は、32GBへの増設が選択肢になります。ただし、メモリは容量だけでなく、DDR4・DDR5の規格、デスクトップ用DIMM・ノートパソコン用SO-DIMMの形状、マザーボードが対応する最大容量、空きスロット数を合わせる必要があります。DDR4とDDR5には互換性がないため、購入前にパソコンやマザーボードの仕様を確認してください。規格の違いや選び方については、DDR4とDDR5どっちがいい?違いと選び方を比較で詳しく解説しています。
対応する規格と必要な容量を確認できたら、条件に合う製品を選びます。増設方法や対応状況に不安がある場合は、無理に取り付けず、製品の取扱説明書やメーカーのサポート情報を確認してください。増設前の選び方や作業手順は、【初心者でも簡単】パソコンのメモリ増設ガイド|選び方・手順・注意点を解説も参考にしてください。
ローカルLLMの生成速度も重視する場合は、メモリとあわせて、グラフィックボードのVRAM容量や使用する実行ソフトの対応状況も確認してください。必要なメモリやVRAMを備えたパソコンを新しく選びたい場合は、AI用途を想定したパソコンから確認できます。
まとめ
メモリ32GBでは、4ビット量子化した7B~14Bクラスを中心に、OSやほかのアプリが使う分を残しながらローカルLLMを動かしやすくなります。27B~32Bクラスも読み込めるモデルがありますが、モデル本体だけで約19~20GBあるため、扱う文章の長さや同時に使うアプリの確認が必要です。
70Bクラスを試したい場合や、ローカルLLMと動画編集などを同時に行いたい場合は、64GBが候補になります。まずは使いたいモデルのファイルサイズと量子化方式を確認し、32GBで足りるかを判断してください。
よくあるご質問(FAQ)
-
Q1メモリ32GBあれば、どんなAIソフトでも問題なく動きますか?
メモリ32GBで動かせるかは、ソフトではなく、選ぶAIモデルのファイルサイズや量子化方式、扱う文章の長さによって変わります。4ビット量子化した7B~14Bクラスは選びやすい範囲ですが、27B~32Bクラスではほかのアプリを含めた使用量の確認が必要です。 -
Q2グラフィックボード(GPU)がなくてもローカルLLMは動きますか?
対応するソフトとモデルであれば、CPUとメモリだけでも動かせます。ただし、生成速度はCPU性能やメモリ帯域に左右され、モデルによっては回答を待つ時間が長くなる場合があります。速度を重視する場合は、グラフィックボードの性能とVRAM容量も確認してください。 -
Q3量子化を行うと、AIの回答の質はどれくらい落ちますか?
回答への影響は、モデルや量子化方式、質問内容によって変わるため、一律の割合では示せません。ビット数を下げるほど必要な容量を抑えられますが、回答の正確さや文章の安定性に影響する場合があります。初めて試す場合は、Q4_K_Mなどの4ビット量子化モデルが選択肢になります。 -
Q4Ollama以外にどんなソフトがありますか?
「LM Studio」も代表的なソフトの一つです。画面上でモデルの検索、ダウンロード、読み込み、チャットまで進められるため、コマンド操作に慣れていない方でも試しやすい設計です。公式サイトで対応OSと動作条件を確認してから導入してください。 -
Q5ノートパソコンのメモリ32GBでもローカルLLMは動きますか?
メモリ32GBのノートパソコンでも、対応するソフトとモデルであれば動かせます。ただし、CPUやグラフィックボード、冷却性能によって生成速度は変わります。また、メモリが基板に固定され、購入後に増設できない製品もあるため、増設を考えている場合は製品仕様を確認してください。 -
Q6メモリを32GBから64GBに増やせば、動かせるモデルは単純に2倍になりますか?
メモリ容量が2倍になっても、生成速度や動かせるモデル規模が単純に2倍になるわけではありません。64GBにすると大きなモデルを読み込む余地は増えますが、生成速度はCPUやグラフィックボードにも左右されます。使いたいモデルのサイズと同時作業の内容から判断してください。
あわせて読みたい関連記事一覧
メモリ64GBは必要?ローカルAIで70Bモデルを動かすための目安を解説